SkillLens:从原始经验到可消费的 Agent Skill
来源:复旦大学、Microsoft Research、上海交通大学研究者联合完成(2026 年论文)
论文:arXiv:2605.23899
开源框架:microsoft/SkillLens
项目主页:microsoft.github.io/SkillLens
为什么一份看起来正确的 Skill,会让 Agent 表现更差?
这是 SkillLens 研究的核心出发点。
传统思路下,我们倾向于认为:只要 Skill 文本写得足够完整、逻辑足够清晰、像专家一样严谨,Agent 就能从中获益。但 SkillLens 的研究结论直接打破了这一直觉——文本质量 ≠ 真实任务效用。
SkillLens 把 Skill 开发从「写提示词」转成「经验工程与配对评测」:不是审阅文本像不像专家,而是追踪经验如何生成、被谁提炼、再被哪个模型消费。
一、定义:不是 Skill 管理器,而是系统研究框架
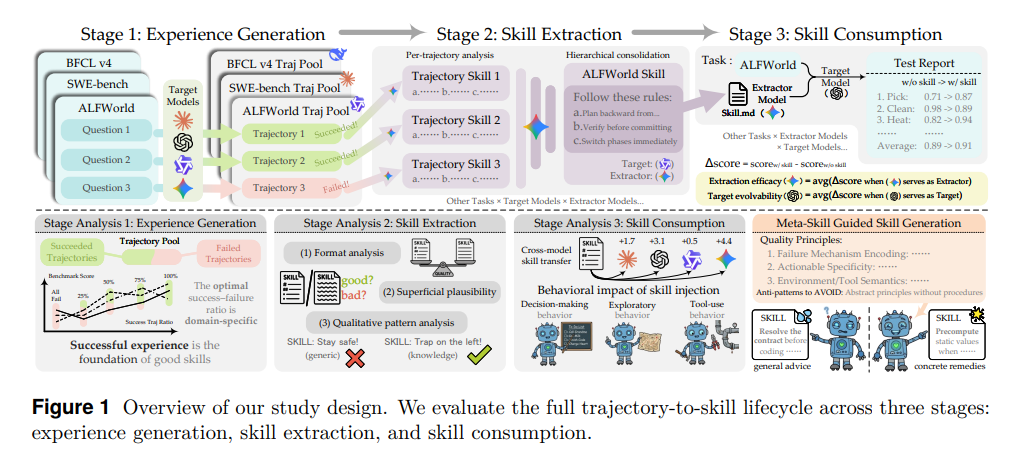
SkillLens 研究的是:怎样从原始 Agent 经验中,自动提炼出领域级 Skill,并判断它进入另一个模型后究竟有没有帮助。
它的边界非常清晰:
- 不关注人工手写
SKILL.md的格式问题 - 不以「生成出来的 Skill 看起来是否合理」为终点
- 真正的研究单位是完整链路:经验来源 → 轨迹统一 → 提炼模型 → 消费模型
四个核心认知
- 人工手写 Skill 难以随任务域扩大而持续规模化
- 只研究最终文本,会遗漏经验生成和目标模型消费两个关键环节
- 文本更完整、更像专家,不代表真实任务分数更高
- 同一份 Skill 对模型 A 有帮助,对模型 B 可能产生负迁移
论文全名:《From Raw Experience to Skill Consumption: A Systematic Study of Model-Generated Agent Skills》
二、Skill 生命周期:经验跨模型传递的介质
论文将 Skill 的完整生命周期划分为三个概念阶段,开源框架在工程层面额外加入了 Schema Normalization 步骤:
| 阶段 | 名称 | 输入 | 输出 | 备注 |
|---|---|---|---|---|
| 01 | EXPERIENCE(生成原始任务轨迹) | 任务与环境 | Raw trajectories | 论文概念链 |
| 02 | NORMALIZE(统一数据结构) | 异构 Benchmark 轨迹 | Trajectory 统一结构 |
开源工程步骤 |
| 03 | EXTRACT(从经验提炼模式) | 成功/失败经验 | Domain-level Skill | 论文概念链 |
| 04 | CONSUME(目标模型执行任务) | Skill + 新任务 | 真实任务得分 | 论文概念链 |
|
注意:Normalization 并非论文三阶段概念链中的研究概念,而是开源实现用于对齐异构轨迹格式的工程步骤。
三、评测坐标系:必须同时记录「谁提炼」与「谁消费」
一份 Skill 没有脱离模型配对的固定价值。
这是 SkillLens 最重要的方法论贡献之一。研究用三层指标来拆分 Skill 的效果:
三层评测指标
| 指标 | 公式 | 含义 |
|---|---|---|
| Δ(Performance Delta) | Score_with_skill - Score_baseline |
最直接的任务增益;负值就是负迁移 |
| EE(Extraction Efficacy) | avg_target_models(Δ | fixed extractor) |
固定提炼模型,观察它在多个目标模型上的平均收益 |
| TE(Target Evolvability) | avg_self-extracted_skills(Δ | fixed target) |
固定目标模型,观察消费自身经验所提炼 Skill 的平均收益 |
读法说明:
Δ:回答单个配对的效果EE:看提炼器跨消费者是否稳健TE:看目标模型利用自身经验的能力
这套坐标会逼迫团队保留无 Skill 基线。没有基线,任何对文本质量的赞美都无法回答最重要的问题:它是否真的改变了任务结果?
四、实验发现:多数配对有效,但四分之一会变差
| 数据 | 含义 |
|---|---|
| 75% | 提炼器—目标模型组合获得正收益 |
| 25% | 组合出现负迁移,不能假设 Skill 普遍有效 |
| 46.4% | LLM 仅看 Skill 文本、两两判断真正更优者的准确率(接近随机) |
重要补充发现
- 最优的成功/失败经验比例会随领域变化,没有通用最优解
- 强执行器不必然是强提炼器:模型会做任务,不等于它能把经验压缩成对其他模型也有效的策略
注意:75%/25% 描述的是官方报告的模型配对结果,不等于任意 Skill 在任意生产环境中的固定成功率。实际效果取决于具体任务、模型与环境。
五、提炼方法:Sequential vs. Parallel
SkillLens 对比了两种主要的 Skill 提炼方法:
| 方法 | 过程 | 定位 | 主要取舍 |
|---|---|---|---|
| Sequential | 对经验进行单次、整体提炼 | 开源框架基线 | 链路短、实现直接;容易让不同轨迹里的细粒度模式被整体摘要吞没 |
| Parallel | 先逐轨迹提取模式,再层次化合并 | 论文主要方法 | 保留局部证据并逐级归并;流程更复杂,需要处理模式去重与冲突 |
Parallel 方法的核心价值不只是「并行更快」,而是改变了信息压缩顺序:
|
先让每条轨迹留下可追溯的局部模式,再把模式逐层合并成领域 Skill,从而降低一次性大摘要抹平差异的风险。
六、Meta-Skill:好的提炼器要写下三类「可行动信息」
研究发现,高质量的 Skill 提炼需要覆盖三个维度:
1. 编码失败机制
不仅记录「失败了」,还要解释:
- 失败为何发生
- 在什么条件下复现
- 它会怎样污染后续决策
2. 给出可执行策略
把抽象建议下沉为目标模型能执行的:
- 具体步骤
- 检查点
- 判定条件
避免只有正确态度、没有操作路径。
3. 列出高风险动作黑名单
明确哪些动作在特定环境中:
- 代价高
- 不可逆
- 常导致连锁错误
让模型在行动前先规避风险。
Meta-Skill 实验结果
- 平均提升约 +1.55 个百分点
- 在 9/9 个「领域 × 目标模型」单元中均有改善(全覆盖正收益)
注意:1.55pp 是论文 Meta-Skill 干预的报告结果,不能当作 Skill 的通用收益,也不等于所有任务都能复现同等增益。
七、实践检查清单
把 Skill 当作需要回归测试的工程制品,而不是一次性写完就放置的文档:
- ✅ 先设置无 Skill 基线 — 保留同任务、同目标模型、同评测条件下的原始表现
- ✅ 做配对实验 — 显式记录提炼器、目标模型、Skill 版本与 Performance Delta
- ✅ 同时维护成功与失败经验 — 不要默认成功轨迹越多越好;按领域探索最优比例
- ✅ 跨模型回归 — 每次修改后,在关键目标模型组合上重跑,寻找负迁移
- ✅ 版本化 Skill — 把来源经验、提炼方法、适用边界和评测结果与文本一起保存
最小记录单元:
|
八、研究边界
SkillLens 是 2026 年的研究与开源框架。它提供了一套更严谨的问题定义、指标与实验结构;论文结果说明模型生成 Skill 值得系统研究,也提醒我们警惕负迁移,但不替代团队在自身任务、模型与环境中的持续验证。
使用这套框架时需要注意:
- 实验结论基于特定 Benchmark(ALFWorld、SpreadsheetBench、SWE-bench Verified、SEAL-0、BFCL v4)
- 不同模型、不同任务域的迁移效果可能与论文报告数据差异显著
- 框架本身仍在持续演进,建议参考最新开源版本
参考资源
| 编号 | 类型 | 说明 | 链接 |
|---|---|---|---|
| S-01 | 官方项目页 | SkillLens Project Page | microsoft.github.io/SkillLens |
| S-02 | 论文 | arXiv:2605.23899 | arxiv.org/abs/2605.23899 |
| S-03 | 开源代码 | GitHub 仓库 | github.com/microsoft/SkillLens |
本文整理自 SkillLens 研究笔记,研究由复旦大学、Microsoft Research、上海交通大学研究者共同完成。