控制循环的艺术 —— 从 ReAct 到 Graph Engineering
2026 上半年到 7 月,社区又给「控制循环」造了好几个新词。把时间线拉出来看就会发现,换的只是名字,讨论的始终是同一件事——怎么控制一个循环:
| 时间 | 概念 | 关键词 |
|---|---|---|
| 2022-10 | ReAct | Thought / Action / Observation |
| 2025-2026 | ReAct Engineering | Prompt / Context / Harness Eng |
| 2026-H1 | Loop Engineering | verification / trigger / rollout loops |
| 2026-07 | Graph Engineering | explicit nodes / edges / state |
1、ReAct:最初的控制是提示词
最早的控制手段就是提示词。ReAct 把「推理轨迹」和「外部行动」交错起来,凑成一个基本循环:
|
- T(Thought):模型写出下一步思考 —— reasoning trace
- A(Action):调用工具或执行环境动作 —— tool / env call
- O(Observation):观察结果回填到上下文 —— feedback from world
这个阶段,人能动的主要就是注入的提示词和 tool calling 的描述。也就是说:
控制点还在上下文里面,回路本身还没被拎出来单独做工程。
ReAct Engineering:围绕循环本身做控制
做多了之后,大家开始围绕 Thought / Action / Observation 这个循环做更系统的控制,于是有了三个「Engineering」:
Prompt Engineering —— 控制模型在 Thought 里怎么计划、怎么拆任务、怎么遵守工具协议(shape Thought)。
Context Engineering —— 控制 Observation 与历史如何进入上下文,减少噪声、保留有效状态(state into Observation)。
Harness Engineering —— 控制工具、评测、日志、环境和运行约束,让 ReAct 循环更可执行(tools / eval / env)。
但这三者动的还是同一个循环,图编排的部分还没被抽出来——Control is still attached to the same loop。
2、Loop Engineering:控制转移到外层
ReAct Engineering 盯的是「循环内部」。Loop Engineering 则把控制点挪到了模型外面:除了循环里的提示词和 tool,还得管——怎么验证、什么时候触发、怎么拿运行记录去持续改进。
三种外围回路
verification loop(验证循环)
每次 agent 完成后,先跑 rubric、单测、E2E、链接检查或人工 review,再决定是否接受结果。
例:PR agent 写完代码 → 跑 E2E → 失败反馈给 agent 重修。
event-driven loop(事件驱动循环)
agent 可由 webhook、cron、IM channel、bug 单等事件自动触发,不必等人手动启动。
例:新 bug 自动进入队列 → agent 复现、定位、提交修复草案。
hill-climbing loop(自升级循环)
把生产 trace、失败案例、grader feedback 汇总,再反过来改 prompt、tool、grader 或 skill。
例:多次失败聚类 → 生成 harness 改进 issue → 审核后更新配置。
到这一步,prompt 已经退成「回路配置」的一部分了。
Loop Engineering 的四层结构
Loop Engineering 可以拆成递进的四层:先让 agent 能干活,再一层层加上验证、触发和持续改进。
| Level | 核心目标 | 做了哪些事 | 相比上一层的递进 |
|---|---|---|---|
| 1 · The Agent | 谁来执行任务 | 给 LLM 上下文和工具,让它 plan、call tools、observe,再继续下一步 | 把一次模型调用扩展成可行动的 agent 循环 |
| 2 · Verification | 做得对不对 | 增加 e2e tests,失败时带反馈重试 | 从会做事 → 可验证地做对事 |
| 3 · Event Driven | 什么时候自动运行 | 接入 webhook、cron、channel、业务事件,让 agent 后台运行 | 从单次运行 → 嵌入生态、规模化运行 |
| 4 · Hill Climbing | 系统怎么越跑越好 | 分析 production traces、grader feedback、失败聚类,改 prompt / tools / graders / skill | 从自动化工作 → 自动化改进工作系统 |
3、Graph Engineering:从控制一个循环,到控制一张网络
Loop 和 Graph 的分界线:
Loop Engineering —— 控制一个循环:围着单个 agent 的执行轨迹,叠加验证、触发、重试、自升级这些外围机制。
Graph Engineering —— 控制一张网络:把多个步骤、agent、API、门控和反馈路径,显式画成节点和边。
其实一个 loop 本身就是一张有向循环图:节点按方向连起来,执行路径绕回前面的节点,形成能反复跑的闭环。Graph Engineering 无非是把节点、边、状态拆开单独写,好描述更复杂的控制流。
图的三要素:Node / Edge / State
NODE(节点):确定性 API · 单次模型 · 完整 agent
- 确定性 API(deterministic step)
- 单次模型(single model call)
- 完整 agent(self-contained loop)
- 运行时路由(dynamic route)
- 校验 / eval gate(re-enter)
EDGE(边):静态边(static),或运行时动态生成边(dynamic)
STATE(状态):共享状态(shared state),但得用 selective context——别把整个上下文一股脑广播出去。
控制结构一挪到外层,能表达的路径就多了。
三种常见的复杂图结构
多 Agent 编排里常见的就三种: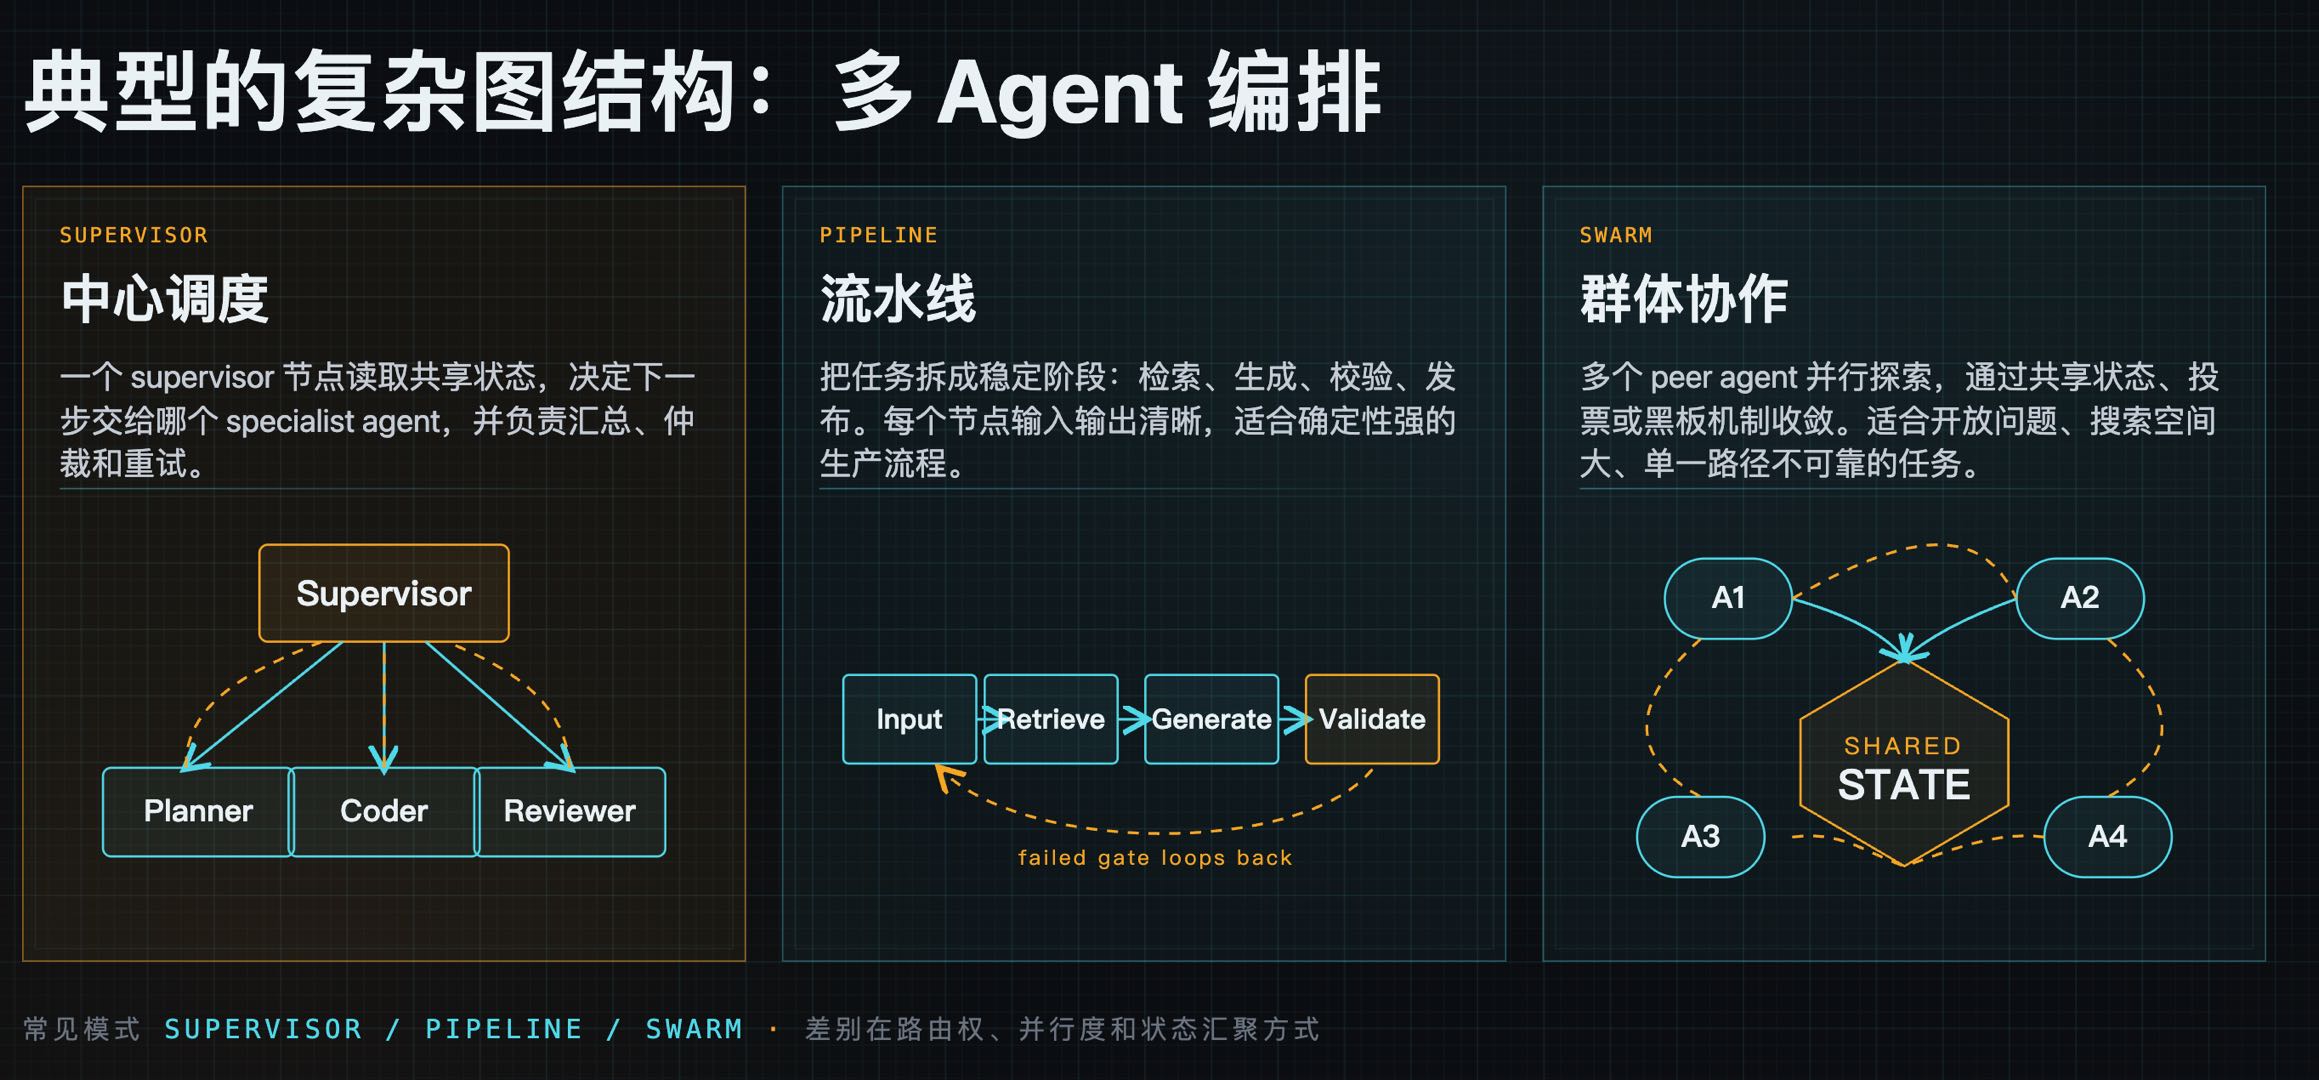
SUPERVISOR(中心调度)
一个 supervisor 节点读取共享状态,决定下一步交给哪个 specialist agent,并负责汇总、仲裁和重试。
结构:Supervisor → { Planner, Coder, Reviewer }
PIPELINE(流水线)
把任务拆成稳定阶段:检索、生成、校验、发布。每个节点输入输出清晰,适合确定性强的生产流程。
结构:Input → Retrieve → Generate → Validate(failed 时 gate loops back)
SWARM(群体协作)
多个 peer agent 并行探索,通过共享状态、投票或黑板机制收敛。适合开放问题、搜索空间大、单一路径不可靠的任务。
结构:SHARED STATE ← { A1, A2, A3, A4 }
三种模式的差别,在于路由权、并行度和状态汇聚方式。
4、范式对比:ReAct vs Loop vs Graph
| 维度 | ReAct | Loop Engineering | Graph Engineering |
|---|---|---|---|
| 目标 | 把推理与行动交错,完成单次任务 | 让 agent 在失败时可验证、可重试、可触发 | 把多步骤、多角色、多反馈网络显式编排 |
| 架构 | 单条 Thought/Action/Observation 轨迹 | agent 外围叠加验证、事件、改进循环 | 节点、边、状态、子图组成可复用网络 |
| 数据结构 | 文本轨迹 + 工具观察 | trace、grader score、触发事件、配置 | typed state、message passing、edge routing |
| 编排方式 | 提示词约束模型行为 | 外层 harness 决定何时跑、何时重试 | 图运行时决定下一节点、并行、分支、回环 |
| 扩展性 | 适合小任务和单 agent | 适合加质量门、自动触发、自改进 | 适合复杂控制流、多 agent、跨流程复用 |
| 限制 | 容易卡在单轨迹,控制点内嵌 | 回路多了会隐式耦合,难以组合 | 需要状态边界设计,否则上下文污染、复杂度上升 |
5、SkillOpt:把 Skill 当作「可训练的外部状态」
铺垫到这里,说说 SkillOpt。它的核心命题只有一句:
Skill 是一个冻结(frozen)Agent 的「可训练外部状态」。
The skill is the trainable external state of a frozen agent.
5.1 同一套训练方法,不同的状态空间
深度学习的训练大概是这样:人来设计考试、教材、评分规则和学习方法,数学系统再根据每次考试的结果,自动去调那几十亿个参数。SkillOpt 把这套方法照搬到文本空间,只是被优化的对象从「权重」换成了「skill 文档」:
| 阶段 | 中文解释 | Weight-space(深度学习) | Text-space(SkillOpt) |
|---|---|---|---|
| 01 实际运行 | 完成一次执行 | Forward pass:输入训练集完成 LLM 推理 | Forward pass:Agent 在当前 skill 下完成任务 |
| 02 评价结果 | 打分 | Loss:计算预测误差 | Score:LLM 对整个执行轨迹打分 |
| 03 找出怎么改 | 求方向 | Backward pass:反向传播得到梯度 | Optimizer reflection:另一个 optimizer LLM 找出优化方案 |
| 04 应用修改 | 更新状态 | Optimizer step:按梯度调整权重 | Bounded edit:对 skills 执行受限的 add / delete / replace |
| 05 验证门 | 防过拟合 | Validation gate:验证集确保泛化 | Held-out gate:分数没提升就不接受变更 |
| 06 跨轮次积累 | 稳定方向 | Momentum:累积历史梯度减少震荡 | Slow / meta update:周期性总结经验,区分快慢更新 |
5.2 SkillOpt Pipeline:程序、Agent 与 LLM 组成的训练图
SkillOpt 的整个流程,本身就是一张 Graph Engineering 意义上的训练图,由三类角色配合:PROGRAM / FRAMEWORK、LLM / AGENT、EPOCH / META LOOP。快循环在一轮内完成候选生成和验证,跨轮次的慢循环攒优化方向: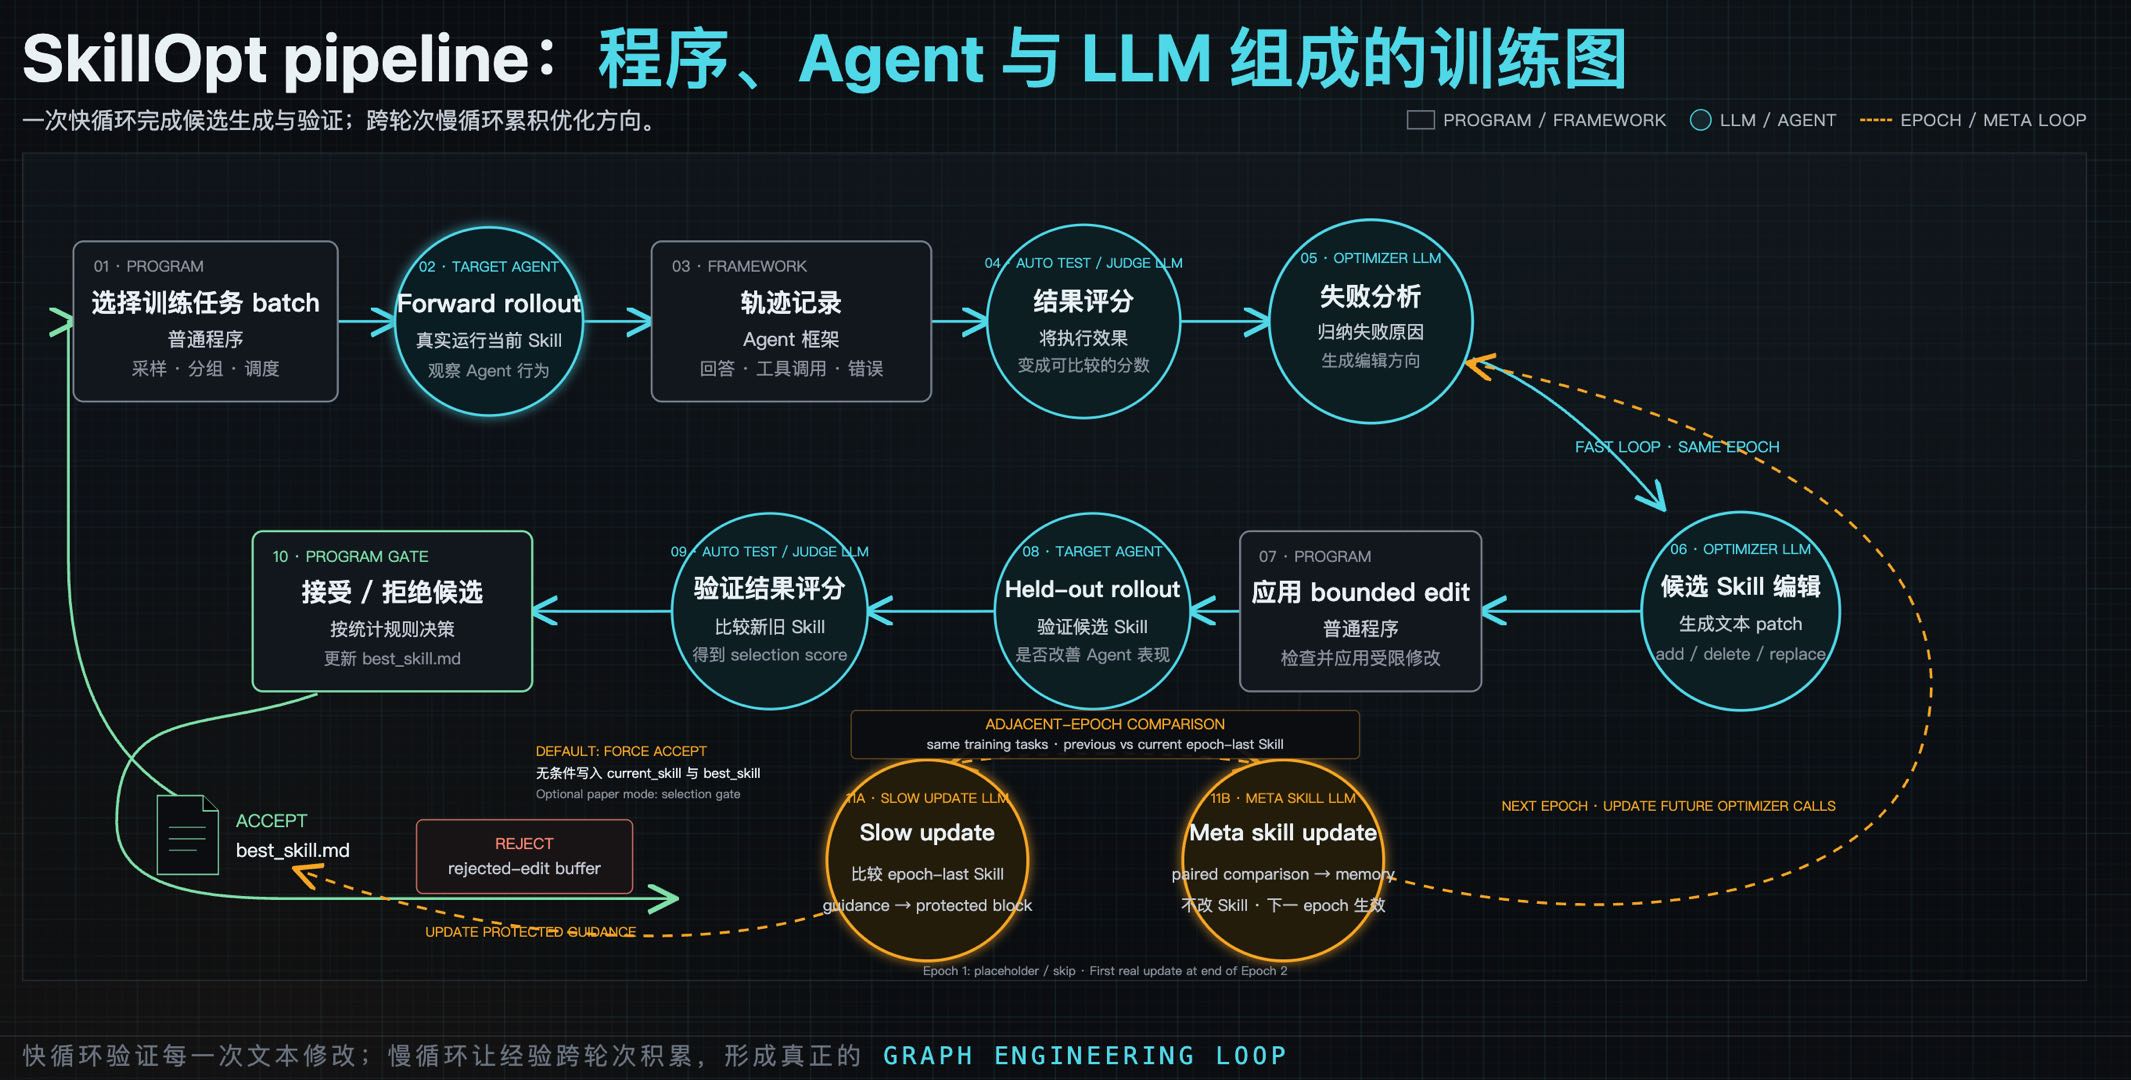
| 步骤 | 执行体 | 动作 | 说明 |
|---|---|---|---|
| 01 · PROGRAM | 普通程序 | 选择训练任务 batch | 采样 · 分组 · 调度 |
| 02 · TARGET AGENT | Agent | Forward rollout | 真实运行当前 Skill,观察 Agent 行为 |
| 03 · FRAMEWORK | Agent 框架 | 轨迹记录 | 回答 · 工具调用 · 错误 |
| 04 · AUTO TEST / JUDGE | LLM | 结果评分 | 将执行效果变成可比较的分数 |
| 05 · OPTIMIZER | LLM | 失败分析 | 归纳失败原因,生成编辑方向 |
| 06 · OPTIMIZER | LLM | 候选 Skill 编辑 | 生成文本 patch:add / delete / replace |
| 07 · PROGRAM | 普通程序 | 应用 bounded edit | 检查并应用受限修改 |
| 08 · TARGET AGENT | Agent | Held-out rollout | 验证候选 Skill 是否改善表现 |
| 09 · AUTO TEST / JUDGE | LLM | 验证结果评分 | 比较新旧 Skill,得到 selection score |
| 10 · PROGRAM GATE | 普通程序 | 接受 / 拒绝候选 | 按统计规则决策,更新 best_skill.md |
| 11A · SLOW UPDATE | LLM | Slow update | guidance → protected block |
| 11B · META SKILL | LLM | Meta skill update | paired comparison → memory(不改 Skill,下一 epoch 生效) |
几个关键机制:
FAST LOOP · SAME EPOCH:快循环负责验证每一次文本修改。
ADJACENT-EPOCH COMPARISON:用同一批训练任务,比较 previous 和 current 的 epoch-last Skill。
默认行为:
DEFAULT: FORCE ACCEPT,无条件写入 current_skill 和 best_skill;也可以切到paper mode: selection gate。决策去向:
ACCEPT → best_skill.md/REJECT → rejected-edit buffer。Epoch 时序:Epoch 1 是 placeholder / skip,第一次真正的更新落在 Epoch 2 结束时。
快循环盯每一次文本修改,慢循环让经验跨轮次攒下来——这才凑成一个完整的 Graph Engineering loop。
5.3 Slow Update 与 Meta Skill:两种不同的记忆
这块设计得比较巧。同一份相邻 epoch 对照(same 20 train tasks),会被写进两份不同的记忆:
Slow Update → Target Agent
Meta Skill → Optimizer LLM
对照就用同样这 20 个任务,比较 previous 和 current epoch-last Skill,分成四类结果:
| 结果类别 | 变化 |
|---|---|
| improved | fail → success |
| regressed | success → fail |
| persistent_fail | fail → fail |
| stable_success | success → success |
11A · TARGET-FACING(Slow Update)
输入:paired trajectories + previous guidance
产出:
slow_update_content→ protected guidance(写入SLOW_UPDATE_START … SLOW_UPDATE_ENDprotected block),FORCE ACCEPT作用对象:下一轮 rollout 的 Target Agent(current + best Skill)
它学的是「Agent 下一轮怎么做」
11B · OPTIMIZER-SIDE(Meta Skill)
输入:edit strategy + previous memory
产出:
meta_skill_result.json→ optimizer memory(reasoning +meta_skill_content),注意:不写进best_skill.md作用对象:下一 epoch 的 Optimizer LLM(reflect / aggregate / rank / learning rate)
它学的是「Optimizer 下一轮怎么改」
Epoch 时序上:
EPOCH 1:仅 protected block
EPOCH 2 END:第一次比较 + 第一批输出
EPOCH 3:两种记忆同时生效
一句话记住:Slow Update 学「Agent 下一轮怎么做」;Meta Skill 学「Optimizer 下一轮怎么改」。
5.4 效果:52 / 52 全部达到最优或并列最优
再看效果。
52 / 52 个评测组合,全部达到最优或并列最优。
这 52 个组合是这么拼出来的:
42 · Direct chat(7 models × 6 benchmarks)
5 · Codex(1 model × 5 benchmarks)
5 · Claude Code(1 model × 5 benchmarks)
= 52 评测组合(Codex / Claude Code 仅测试 GPT-5.5,两组均不含 ALFWorld)
以 GPT-5.5 · Direct chat 为例,平均准确率 58.8 → 82.3(+23.5 pp):
| Benchmark | 准确率 |
|---|---|
| SearchQA | 87.3 |
| SpreadsheetBench | 80.7 |
| OfficeQA | 72.1 |
| DocVQA | 91.2 |
| LiveMath | 66.9 |
| ALFWorld | 95.5 |
三个点值得留意:
程序性任务提升最大:Spreadsheet +38.9;OfficeQA +39.0;LiveMath +29.3 pp。
小模型的相对提升更明显:Qwen3.5-4B 在 Spreadsheet 上 9.3 → 23.9(约 ×2.6)。
三类运行环境都有提升:Direct chat +23.5;Codex +24.8;Claude Code +19.1 pp。
数据来源:SkillOpt, arXiv 2605.23904 · Table 1。
6、畅想未来:更长的自运行循环
最后把眼光放远一点。有个判断是这样的:
未来拼的不是更长的回答,而是更长的自运行循环。
随着**任务时限(task horizon)**变长,人和模型的关系也在变:
| 时限 | 形态 | 人的角色 | 定位 |
|---|---|---|---|
| MINUTES | Chat / Autocomplete | 全程 human in the loop,持续操舵 | 模型是响应者 |
| ≈ 1 HOUR | Local Coding Agent | 人在旁,随时接管 | 模型是执行者 |
| MULTI-HOUR | AI Coworker / Async Agent | 人委派并审查结果 | 模型开始成为同事 |
再往前,就是让系统自己改进系统——Jeff Dean 说的 Discovery Loop:
|
这套东西不只用在机器学习上:任何有可衡量目标的科学和工程问题,都可能进到这种紧凑的自动实验循环里。
而 AGI 本身,也更像一个动态系统,而不是一个孤零零的模型:
|
按「距离」由近到远:
| 距离 | 能力 |
|---|---|
| NEAR / OOD | 直接推理 |
| FARTHER | 长时间 reasoning / search |
| DISTANT | 查资料 + 工具 + 环境反馈 |
| UNKNOWN | 实验 → 数据 → 假设 → 验证 → 学习 |
乐观估计:模型越强、循环越长,harness 的杠杆就越大。